在 DSH 对话面板里与任意已配置模型对弈 15×15 五子棋,支持人机、双 AI、暂停手动接管,并可分别编辑黑白双方提示词。

- 语言
- TypeScript
- License
- MIT
- 分支
- main
安装
$ dsh plugin --profile web add @yejiming/dsh-gomoku在终端中运行以上命令,通过 dsh CLI 安装此插件。可在右上角切换 Profile。 第一次用 dsh?看这篇新手教程
对话式安装
帮我安装 DeepSeek Harness 插件 omdsh-dev/dsh-gomoku:先查看仓库 https://github.com/omdsh-dev/dsh-gomoku 确认安全性,然后执行安装命令并验证插件加载成功。
把这段指令粘贴给 DSH Web GUI 里的助手,由它代你完成安装与验证。
一句话定位
在 DSH 对话面板的"五子棋"标签页里和任意已配置的模型下一盘 15×15 五子棋,支持人机对战、双 AI 对战、暂停手动接管、双方提示词分别编辑,每步落子由模型推理产生。
核心能力
- 提供 15×15 标准棋盘,支持自由式五子棋(无禁手,双三、双四、长连均合法,连成五子即胜)
- 三种对弈模式:执黑先手、执白后发、双 AI 互搏,模式按钮位于棋盘下方
- 黑白双方可分别选择模型与思考档位(Off / High / Max),互不影响;模型不支持所选档位时自动回落默认
- 黑白 AI 的系统提示词可在两侧面板常驻编辑、保存和恢复默认;编辑后的提示词会原样发送给模型
- 双方各自的思考记录以折叠列表分别列在棋盘左右两侧,可展开查看完整推理文本
- 暂停按钮随时中断 AI 思考,暂停期间可为黑白双方轮流落子;继续后 AI 从中断的那一手恢复
- 棋局保存在浏览器模块级 store,关闭弹窗或切换 tab 不重置棋盘、不打断在飞的 AI 请求
- 流式响应瞬时失败(断连、限流等)在尝试预算内自动重试,不让单步棋轻易失败
技术实现
- 语言: TypeScript(含 React 18 浏览器组件)
- 关键依赖:
@deepseek-ai/dsh-llm(流式调用与 BlockAssembler)、@deepseek-ai/dsh-host-webserver(注册 HTTP 路由)、@deepseek-ai/cordis(宿主插件机制)、@deepseek-ai/dsh-client-ui-slots(注册对话视图 tab)、schemastery(loader 配置 schema) - 架构模式: 双半插件——
src/index.ts是节点半,在宿主里通过 cordis 注册/plugins/gomoku/{prompt,models,move}三个 HTTP 路由,仅仲裁 AI 落子;src/client/index.ts是浏览器半,向会话视图槽位注入一个名为"五子棋"的新标签页(顺序号 20,位于 Trajectory 之后),承载棋盘与两侧面板 - 入口文件:
src/index.ts(节点半 apply)、src/client/index.ts(浏览器半 apply),构建产物分别为lib/index.js与lib/client.js,通过同一个包 ID 装载
适用场景
想让 DSH 在正事之外多一个轻松玩法的用户。模型不再只用来写代码、做表格,而是直接坐在棋盘对面——你可以和 DeepSeek 下一盘围观它的思考链,也可以让两个不同模型对弈比较它们的判断力;想研究提示词对棋力的影响,分别编辑黑白两边的系统提示词就能现场试调。
前置依赖与兼容性
| 依赖 | 最低版本 | 说明 |
|---|---|---|
| DSH | 0.1.0-rc.6 | 插件依赖 @deepseek-ai/dsh-host-webserver 暴露的 webServer 服务注册路由,更早版本没有该服务,插件层会一直 pending |
| React | 18.2.0 | 浏览器半使用 React 18 渲染棋盘与面板,由宿主 dsh 在运行时提供 |
| Cordis | 4.0.0-rc.7 | 宿主运行时框架 |
| 平台 | 跨平台 | 纯 web 插件,无原生模块,无操作系统限制 |
安装方式
dsh plugin --profile web add github:omdsh-dev/dsh-gomoku
配置项
| 配置 | 类型 | 说明 | 默认值 |
|---|---|---|---|
| moveTimeoutMs | 整数(≥1000) | 一次 AI 落子请求的端到端截止时间。浏览器端每次请求都发固定值,界面不再暴露调整。 | 3000000(毫秒,约 50 分钟) |
| maxMoveOutputTokens | 整数(≥8) | 一次 AI 落子回复的输出 token 上限。推理模型会把思考计入同一预算,默认留得较宽;截断的回复只要 JSON 完整仍会被解析,只有 JSON 丢失才计入失败。 | 32000 |
| maxMoveAttempts | 整数(1–3) | 每次落子请求允许的 AI 尝试总次数;最后一次尝试附带纠正反馈。 | 3 |
常见问题
Q: 我能自己编辑 AI 的系统提示词吗?
A: 可以。棋盘两侧各有"黑方提示词""白方提示词"编辑框,随改随存;保存后下一手即按你修改后的文本发送给模型,每方都有"恢复默认"按钮回到插件内置的规则文本。
Q: 黑白双方能选不同的模型吗?
A: 可以。两侧面板各自的下拉菜单从宿主已注册的 provider/model 路由里选,黑方选 DeepSeek、白方选另一个模型即可;模型下拉只显示宿主已配置好的那些。
Q: 思考档位(Off / High / Max)有什么用?
A: 它把档位作为 reasoning effort 转发给所选模型,仅当该模型声明支持该档位时才会被采用;不支持的档位会回落到模型自身的默认思考强度,而不是让请求失败。开启后会消耗更多输出 token。
Q: 双 AI 对弈中我能介入吗?
A: 可以随时点棋盘下方的"暂停"按钮进入手动接管模式;此时 AI 思考被中断,黑白双方都由你轮流落子,再次点击"继续"后 AI 从中断的那一手恢复思考。
Q: AI 给出的落子坐标越界或落在已有棋子上怎么办?
A: 服务端会拒绝该回复并把拒绝原因(含坐标与上一次完整输出)作为纠正反馈发给模型重试,直到用完默认 3 次尝试;如果三次都不合法,棋盘状态栏会显示具体错误,并出现"重试"按钮让你手动发起新请求。
Q: 棋局会保存到云端吗?
A: 不会。棋盘、提示词、模式等所有状态都保存在浏览器的模块级 store 里,关闭 DSH 窗口或刷新页面后状态会清空;落子请求本身也独立于任何 agent 会话,绝不会写入你的对话日志。
Q: 怎么彻底卸载这个插件?
A: 运行 dsh plugin --profile web remove @yejiming/dsh-gomoku 即可同时移除依赖与对应的 gomoku 层。
上手难度
入门 — 安装后棋盘即出现在对话视图右侧"五子棋"标签页里,点"新开局"即可开战;模型与提示词有默认值,无需任何配置就能下一盘。
已知问题与限制
- 模型必须能稳定返回结构合法的 JSON 落子(
{"move": [row, col]});思考模型把思考计入同一输出预算,若回复被截断且 JSON 不完整,会触发一次重试 - 浏览器端向节点半发送的
moveTimeoutMs(3000000 毫秒)与maxMoveOutputTokens(32000)为硬编码常量,界面不提供调整入口(详见src/client/store.ts:90-92) - 双 AI 对弈模式下任一方连续失败 3 次会留下错误日志并等待手动"重试"按钮,AI 不会自动恢复
- AI 思考超时由客户端看门狗以"节点半截止时间 + 5 秒"为窗口主动中断(详见
src/client/store.ts:336),并非由服务端主动通知 - 节点半将网络/限流类瞬时错误码(EMPTY_RESPONSE / RATE_LIMIT / SERVER / TIMEOUT / TRANSPORT)视为可重试(详见
src/index.ts:356-368),鉴权、参数校验与取消类错误不会被重试
English · 简体中文
五子棋(Gomoku)· 在 DSH 里和 AI 杀一盘
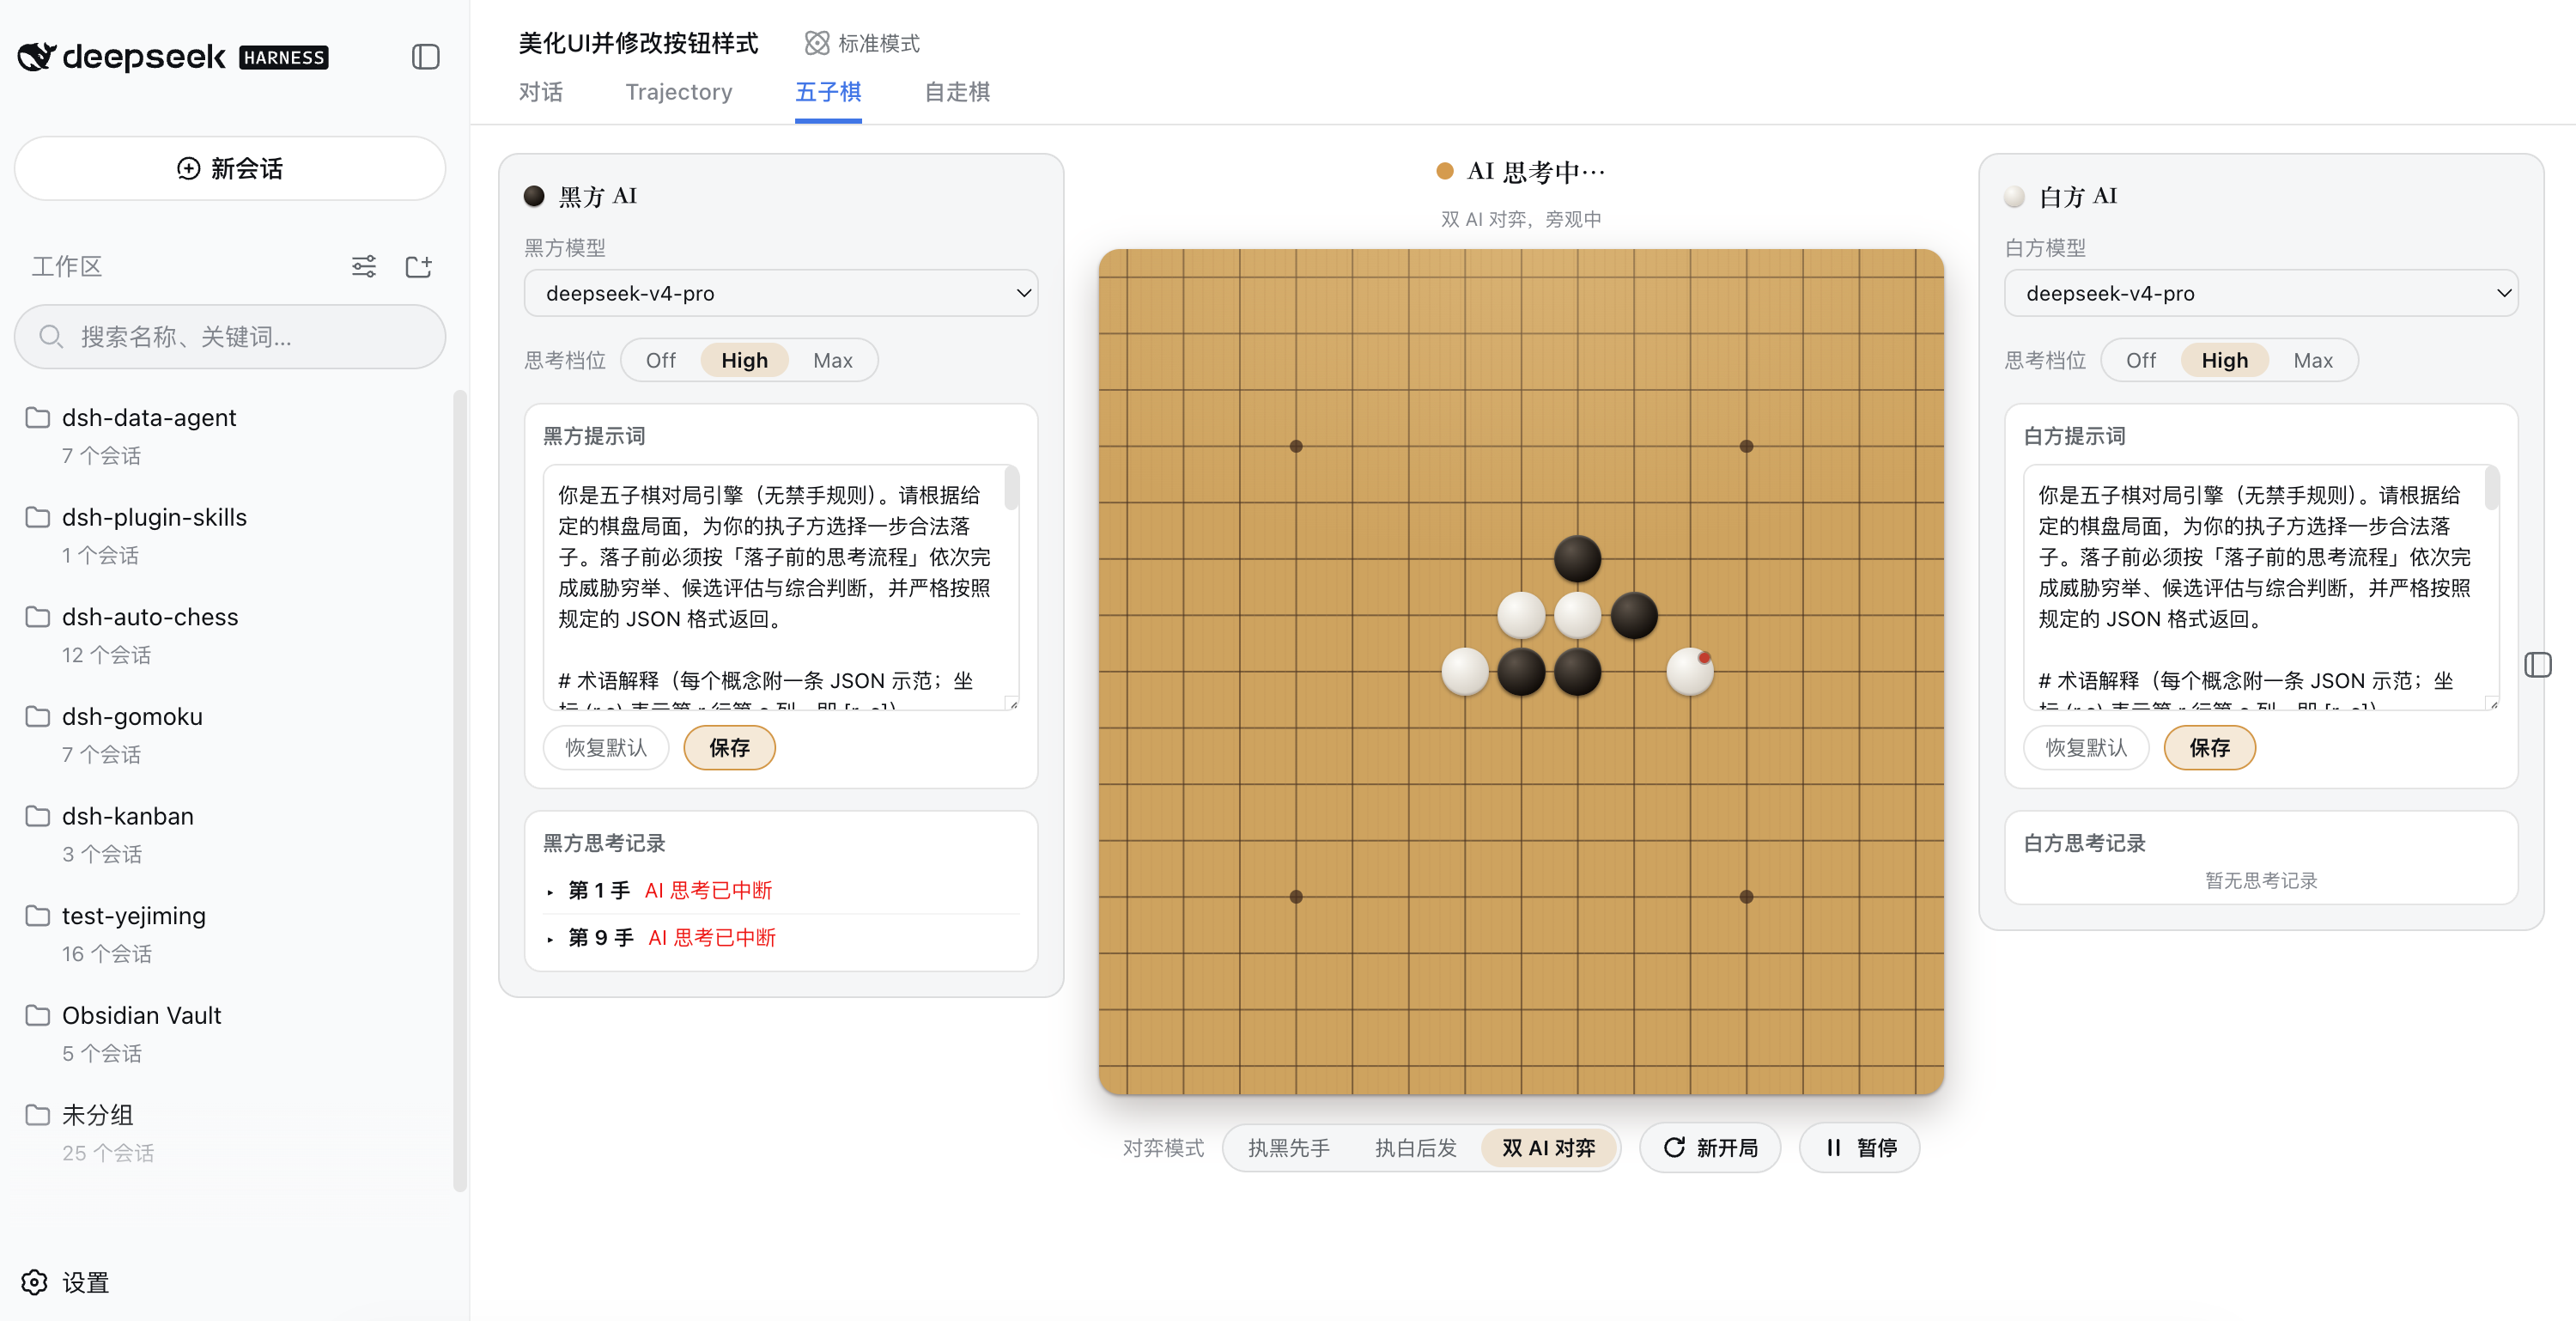
总是让 AI 帮你写代码、做表格?这次换它陪你下棋。@yejiming/dsh-gomoku 是 DeepSeek Harness 的五子棋插件:在 DSH 侧边栏摆上一盘 15×15 的棋盘,让 DeepSeek 或任何你配置好的模型执子对弈。
这里没有搜索算法,也没有启发式剪枝——每一步落子都来自 LLM 纯粹的推理与判断,堪称对模型「思考能力」最直观的考验。最过瘾的当属双 AI 对战:让两个模型同台厮杀,谁的推理更缜密、更懂审时度势,一局见分晓。
想更进一步?黑、白两方的系统提示词可以分别编辑,约束 AI 落子前的思维链,亲眼看着棋力在你的「调教」下节节攀升——输赢先不论,围观棋路、偷师几手也不亏。
最贴心的是:棋盘弹窗想开就开、想关就关,对局和 AI 的思考在后台照常进行。一边用 DSH 处理正事,一边偷空落一子,摸鱼与工作两不误。
主要功能
- 人机与双 AI 对弈:支持执黑、执白、双 AI 对弈三种模式,15×15 无禁手规则(双三、双四、长连均合法,连成五子及以上即胜)。对弈模式与新开局按钮位于棋盘下方。
- 黑白 AI 分别设置:黑、白两方可分别选择模型与思考档位(Off / High / Max),互不影响;模型不支持所选档位时自动回落其默认档位。
- 思考过程分侧展示:黑、白两方的思考记录分别列在棋盘左右两侧(与各自的 AI 设置同侧),默认折叠,点击某手可展开该步的完整推理文本。
- 暂停与手动接管:棋盘下方【新开局】按钮右侧的【暂停】按钮可随时中断 AI 思考(两者均为「图标 + 文字」的胶囊按钮:⟳ 新开局、⏸ 暂停、▶ 继续,暂停中按钮转为琥珀色高亮);暂停期间你可为黑白双方轮流落子,没有步数限制,再次点击【继续】后 AI 恢复思考。
- 固定超时与输出上限:单次落子的端到端超时固定为 3000000 毫秒(3000 秒)、输出 token 上限固定为 32000,随每次落子请求发送,不在界面中暴露。
- 黑白提示词分开编辑:黑、白两方 AI 的系统提示词分别在棋盘左右两侧的面板中常驻展示、随时编辑,各自可一键恢复默认。默认提示词包含规则、术语(活二/活三/眠三/双活三/四三/防守要点等,附 JSON 示范)、强制思考流程(穷举威胁→分析候选→综合判断)与高水平 Few-shot 对弈示例(每条附返回案例)。
- 弹窗关闭不中断对局:棋局保存在浏览器端 store 中,关闭棋盘弹窗既不会重置棋局,也不会中断正在进行的 AI 思考,可以一边使用 Harness 主功能一边对弈。
- 瞬时失败自动重试:流式响应中断(连接断开、限流等瞬时传输故障)会在尝试预算内自动重试,不会直接让整步棋失败。
快速安装
支持三种安装方式,均无需本地构建(构建产物 lib/ 已提交进仓库,且不设 prepare/prepack 脚本)。DSH 的标准插件安装机制是「组合包 → profile」:插件包在 package.json 中声明 dsh.bundle 并附带 patch 文件(cordis.patch.yml),用户用 dsh plugin 把它安装进任意 profile。
方式一:npm 安装(推荐)
# 从 npm 安装(首次使用会初始化该 profile)
dsh plugin --profile demo add @yejiming/dsh-gomoku
方式二:GitHub 源码安装
# 从 GitHub 源码安装(仓库已提交构建产物 lib/,安装时无需构建)
dsh plugin --profile demo add github:omdsh-dev/dsh-gomoku
方式三:本地 checkout / tarball 安装
# 从本地 checkout 安装(在插件目录内执行)
dsh plugin --profile demo add .
# 从 tarball 安装(tarball 由 pnpm pack 生成,文件名形如 yejiming-dsh-gomoku-<版本>.tgz)
pnpm pack
dsh plugin --profile demo add ./yejiming-dsh-gomoku-0.0.1.tgz
以上方式都直接使用仓库内提交的预构建产物(lib/),安装时不需要执行构建脚本——从 git 安装也无需在 profile 的 pnpm-workspace.yaml 里配置 allowBuilds。要求 dsh ≥ 0.1.0-rc.6:插件使用 @deepseek-ai/dsh-host-webserver 的 webServer 服务,更早版本的 dsh 没有该服务,插件行会一直 pending。若 pnpm 提示 peer 依赖警告,可忽略:所需服务由宿主 dsh 在运行时提供。
首次使用 dsh plugin 会初始化该 profile(@deepseek-ai/dsh-base 作为第一个组合包);安装后先用 --dump-config 验证层,再启动:
dsh --profile demo --dump-config   # 输出中应出现 gomoku 层
dsh --profile demo
移除:dsh plugin --profile demo remove @yejiming/dsh-gomoku 会同时移除依赖与对应层。
架构
棋局本身(状态、回合、胜负判定)在浏览器界面中;服务端只仲裁 AI 落子,因此非法回复在服务端被拒绝,不会破坏浏览器端的棋盘。游戏采用自由式五子棋(无禁手):黑方可以自由下双三、双四与长连——任意方向连续五子及以上即获胜。规则、返回格式、落子前思考流程、战术与示例都在默认系统提示词中;用户可以在界面中手改提示词,修改后的文本会原样作为系统提示词发送。
配置
所有字段都有 loader 默认值;无库级默认值。
| 键 | 说明 |
|---|---|
moveTimeoutMs | 单次 AI 落子尝试的端到端截止时间(默认 3000000 毫秒,即 3000 秒)。浏览器端每次都发送固定值,界面不再提供调整。 |
maxMoveOutputTokens | 单次 AI 落子回复的输出 token 上限(默认 32000)。推理模型会把思考计入输出预算,因此默认值较宽松;截断的回复只要 JSON 完整仍会被解析,只有 JSON 丢失才触发重试。浏览器端每次都发送固定值,界面不再提供调整。 |
maxMoveAttempts | 每次落子请求的 AI 尝试总次数;最后一次尝试附带纠正反馈(默认 3)。 |
模型调用
五子棋落子请求(Auxiliary gomoku move request)
What the model sees
每次 AI 落子都是发往所选 provider/model 路由的一次独立辅助请求。系统提示词是黑、白两方各自编辑后的文本(在棋盘两侧面板中随时可改),某方未编辑时用下方的包默认文本;唯一的用户消息包含 15×15 棋盘文本(首行列号,随后 15 行每行以行号开头,每格一个 B/W/· 字符)、AI 执子方,以及(重试时)上一次非法回复与拒绝原因。落子请求还可携带思考档位(off/high/max):仅当所选模型声明支持该档位时,服务端才会把它作为请求的 reasoning effort 转发;不支持的档位回落到模型自身默认值,而不是让请求失败。浏览器端固定发送按请求 moveTimeoutMs(3000000)与 maxMoveOutputTokens(32000)覆盖值。回复中的推理块会随落子、和棋或错误结果以 reasoning 字段返回给浏览器。
本字段的原文(Verbatim text for this field, when needed)
你是五子棋对局引擎(无禁手规则)。请根据给定的棋盘局面,为你的执子方选择一步合法落子,并严格按照规定的 JSON 格式返回。

# 术语解释(每个概念附一条 JSON 示范;坐标 (r,c) 表示第 r 行第 c 列,即 [r, c])
- 活二:两子相连,且两端都能继续延伸。
  {"概念": "活二", "示范": "白子 (5,5)(5,6),(5,4) 与 (5,7) 均为空"}
- 冲三:三子相连,只有一端开口,下一步可成冲四。
  {"概念": "冲三", "示范": "黑子 (3,0)(3,1)(3,2),仅 (3,3) 一端为空"}
- 活三:三子相连,两端都是空位,下一步可成活四;对手出现活三时,必须立即堵住其中一端。
  {"概念": "活三", "示范": "黑子 (3,3)(3,4)(3,5),两端 (3,2) 与 (3,6) 均为空", "应对": {"move": [3, 2]}}
- 冲四:四子相连,只有一端开口,下一步即成五;必须立即堵住开口端。
  {"概念": "冲四", "示范": "黑子 (3,3)(3,4)(3,5)(3,6),(3,2) 已有白子,仅 (3,7) 一端为空", "应对": {"move": [3, 7]}}
- 活四:四子相连,两端都是空位,下一步必成五,无法阻挡。
  {"概念": "活四", "示范": "白子 (7,3)(7,4)(7,5)(7,6),两端 (7,2) 与 (7,7) 均为空"}
- 五连:任意方向连续 5 颗及以上己方棋子,即获胜(长连同样算赢)。
  {"概念": "五连", "示范": "黑子 (8,5)(8,6)(8,7)(8,8)(8,9) 连成五子,黑方直接获胜"}

# 棋盘
- 棋盘为 15×15,共 225 个交叉点。行 row 与列 col 均从 0 到 14,坐标写作 [row, col]。
- 棋盘在消息中以 16 行文本给出:第 1 行是列号(0 到 14,与每列对齐),随后 15 行每行以行号开头,后面是该行的 15 个交叉点,每格一个字符:`B` 表示黑子,`W` 表示白子,`·` 表示空交叉点。
- 黑方先手,双方轮流落子;每一步只能落一子,且必须落在空交叉点上。

# 胜负规则
- 任意一方在横、竖或两条斜线(共 4 个方向)中的任一方向上,率先形成连续 5 颗及以上己方棋子,即获得胜利。
- 本局采用无禁手规则:黑方没有任何落子限制。专业规则中禁止的「双三」「双四」「长连」(连续六子及以上)在本局中全部允许——只要连成五子及以上,无论用什么手段都算赢。
- 棋盘没有空位且无人获胜时为和棋。

# 基本战术(落子前逐条检查;沿横、竖、两条斜线共 4 个方向分别扫描双方棋型;每条附返回案例)
1. 取胜优先:若本步能直接形成五连(包括把己方四连补成五连),立即落子取胜,不要贪图其他棋型。
   案例:黑方执子,黑方在 (6,6)(6,7)(6,8)(6,9) 已有四连,(6,10) 为空。
   返回:{"move": [6, 10]}
2. 必防冲四:若对手已有四连且只差一子即成五,必须立即堵住其成五点(四连只有一端开口时堵住开口端),否则对手下一步直接获胜。
   案例:白方执子,黑方在 (4,4)(4,5)(4,6)(4,7) 已有四连,(4,3) 已有白子,只剩 (4,8) 一个成五点。
   返回:{"move": [4, 8]}
3. 活三必挡:若对手已形成活三(三连且两端都是空位),必须立即堵住其中一端;否则对手下一步形成两端都能成五的活四,将无法阻止。
   案例:黑方执子,白方在 (7,3)(7,4)(7,5) 连成三子,两端 (7,2) 与 (7,6) 均为空。
   返回:{"move": [7, 2]}
4. 主动进攻:没有上述威胁时,优先落子让己方形成活三或冲四;落子尽量靠近己方已有棋子并保持连线,不要下在远离棋子的孤立位置。
   案例:黑方执子,黑方已有 (5,5)(5,6) 两连,(5,4) 为空,在 (5,4) 落子可形成两端 (5,3)(5,7) 皆空的活三。
   返回:{"move": [5, 4]}
5. 双重威胁:一个落点若能同时形成两个威胁(如双三、四三)应优先选择;防守时若能一子同时堵住对手多个威胁则更佳。
   案例:黑方执子,黑方已有横向 (5,3)(5,4) 与纵向 (3,5)(4,5) 各两连,在 (5,5) 落子可同时形成两个活三(双活三)。
   返回:{"move": [5, 5]}

# 返回格式(必须严格遵守)
只返回一个 JSON 对象,不要输出任何思考过程、解释、Markdown 代码块或前后缀(思考会占用输出预算,导致回复被截断):
- 正常落子:{"move": [row, col]}
- 和棋:{"draw": true}
- 局面无法理解:{"error": "一句话说明原因"}

# 正确案例
示例 1:黑方执子。棋盘上第 7 行第 8 列(row=7, col=8)为空,黑方在此落子即可形成连续五子并获胜。
返回:{"move": [7, 8]}
错误示范(禁止返回):"我认为应该下在这里。{"move": [7, 8]}" —— 带解释的文字不是合法输出。

# 坐标校验
row 与 col 必须是 0 到 14 的整数,且目标交叉点必须为空;违反任何一条都是非法落子,你会收到纠正提示并重新选择。
Token effect
辅助请求按棋盘构造成本消耗 token(约 530 个固定字符——带行列标注的棋盘加构句——外加用户编辑后的提示词)以及 maxMoveOutputTokens(默认 8192)。高于 off 的思考档位会增加模型的思考 token,计入同一个输出预算。该请求与任何 agent 对话相互独立,绝不写入会话日志。命中输出上限的回复仍会先尝试解析出完整 JSON 对象,解析失败才计为一次失败尝试。
KV Cache effect
辅助请求是独立的模型请求;其提示词随每个棋局位置变化,因此与 agent 流量之间没有稳定的共享前缀。用户编辑系统提示词会整体替换文本,使 provider 侧的跨局前缀复用失效;默认提示词只在未编辑时保持稳定。
查看使用指南 →
该插件的安装步骤、关键要点、FAQ 与兼容性说明(基于已收录字段派生)。
收录徽章

[](https://deepseek-plugin.org/plugins/omdsh-dev/dsh-gomoku)把这段 markdown 粘贴到你的 GitHub README,链接回本插件详情页。徽章只声明已被本站收录,不代表安全认证。