面向 DSH 的金融风控规则挖掘插件:自动完成数据质检、单规则挖掘、并行 OR 规则组合最优搜索并输出自包含 HTML 报告。

- 语言
- JavaScript
- License
- MIT
- 分支
- main
安装
$ dsh plugin --profile web add dsh-plugin-risk-rule-design在终端中运行以上命令,通过 dsh CLI 安装此插件。可在右上角切换 Profile。 第一次用 dsh?看这篇新手教程
对话式安装
帮我安装 DeepSeek Harness 插件 pypcfx-glitch/risk-rule-design:先查看仓库 https://github.com/pypcfx-glitch/risk-rule-design 确认安全性,然后执行安装命令并验证插件加载成功。
把这段指令粘贴给 DSH Web GUI 里的助手,由它代你完成安装与验证。
一句话定位
为 DSH 提供金融风控规则挖掘能力:给定一份带二分类标签的 CSV 数据(特征 X 与好坏标签 y),自动完成数据质量检查、单规则挖掘、并行 OR 规则组合最优搜索,并输出自包含的 HTML 分析报告。
核心能力
- 自动数据质检:识别并剔除 ID/流水号/常量/近似唯一/高缺失等无用特征,统计 y 分布与重复行,给出推荐 X 清单
- 单规则挖掘:连续变量按分位数(默认 1/3/5/95/97/99%)遍历阈值,并尝试「选大 x>=q / 选小 x<=q」两个方向生成候选;分类变量取高坏浓度单值与并集;缺失值也作为一类候选规则
- 并行 OR 规则组合最优搜索:采用逐层遍历树策略,先以单规则 Lift 前 5% 轮番作第一条规则种子,再按增益逐层扩展,直到召回率无法再提高
- 五种评估目标:默认 f1(精准率×召回率最平衡),另支持 top_lift / composite / max_lift / min_hit
- 自包含 HTML 分析报告:内联 CSS 与 SVG 图表,含数据集概览、单变量条形图、组合累积曲线、命中率-Lift 散点图、精准率-召回率曲线,浏览器直接打开
- 同时注册 1 个专家技能「risk-rule-design」与 3 个工具(rrd_profiling / rrd_mining / rrd_report),可在 DSH 会话中被模型或用户调用
技术实现
- 语言: JavaScript(ESM,type: module)
- 关键依赖: 无(仅使用 Node 内置的
node:fs/promises、node:path与相对导入) - 架构模式: 通过
cordis.patch.yml将插件插入 DSH 宿主(npm 包名形态),在apply(ctx)中调用tools.register与skills.register注册工具与技能;组合搜索使用紧凑位集(Bits/Uint32Array + popcount 表)加速命中计算 - 入口文件:
src/index.js(注册入口);核心引擎src/engine.js(CSV 解析、类型推断、单规则挖掘、组合搜索);报告生成src/report.js(自包含 HTML)
适用场景
风控策略人员、数据分析师需要对一份带好坏标签的历史样本做拒绝规则挖掘时使用。典型用法是:你只需要把 CSV 数据集路径给到插件,告诉它哪一列是 y(如 default_flag),插件就会自动跑完「数据质检 → 单规则 → 组合 → 报告」全流程,并告诉你「拒绝任一条规则即拒绝」的最佳组合长什么样。
前置依赖与兼容性
| 依赖 | 最低版本 | 说明 |
|---|---|---|
| DSH 宿主 | 未声明 | 通过 cordis.patch.yml 注入,需 DSH 支持 cordis patch 机制 |
| Node | >= 18 | 来自 package.json#engines.node;插件零依赖,仅使用 Node 内置模块 |
| 平台 | 跨平台 | 纯 JavaScript,无原生模块,无 os/cpu 限制 |
| 原生模块 | 无 | 零外部依赖,不依赖任何 node-gyp / 原生扩展 |
安装方式
dsh plugin --profile web add dsh-plugin-risk-rule-design
配置项
本插件本身无需配置文件。三个工具的核心参数(rrd_mining 的可调项)如下:
| 参数 | 类型 | 说明 | 默认值 |
|---|---|---|---|
| dataset | 字符串(必填) | 数据集 CSV 文件的绝对路径(必须包含表头) | — |
| target | 字符串(必填) | 目标变量 y 的列名(二分类:bad=1 / good=0) | — |
| objective | 枚举 | 组合评估目标:f1 / top_lift / composite / max_lift / min_hit | f1 |
| hitRateBudget | 0~1 | 组合命中率(通过率减少)预算上限 | 0.5 |
| cutQuantiles | 整数数组 | 连续变量的切分分位数(%),遍历「选大/选小」两个方向 | [1, 3, 5, 95, 97, 99] |
| minSupport | 0~1 | 单规则最小支持度(命中占比) | 0.01 |
| minLift | 1~100 | 单规则最小 Lift | 1.05 |
| maxRules | 1~12 | 组合规则条数上限 | 8 |
| maxCandidates | 1~40 | 候选规则池上限 | 14 |
| reportDir | 字符串 | HTML 报告与挖掘快照的输出目录 | 数据集所在目录 |
| title | 字符串 | 报告标题 | 风控规则挖掘分析报告 |
rrd_profiling 与 rrd_report 的参数更少:profiling 仅
dataset+target(外加可选features/exclude);report 仅snapshot(必填)+ 可选reportDir/title/note。
常见问题
Q: 目标变量 y 需要什么格式?
A: 必须是二分类标签。引擎接受 0/1、true/false、good/bad、正常/违约、违约/未逾期、是/否、yes/no 等等价写法,会自动映射为 bad=1/good=0。单一取值(全部为 0 或全部为 1)会直接报错「目标列取值单一,无法挖掘」。
Q: 数据集必须是什么格式?
A: 仅支持 CSV(带表头行)。引擎自带 CSV 解析器,支持引号、转义引号、引号内逗号/换行、CRLF、BOM 等情况。注意 README 示例中出现的 .xlsx 是引导文案,引擎实际只读取 CSV 文本,xlsx 需要先转成 CSV。
Q: 数据量很大时会不会跑得很慢?
A: 组合搜索阶段若行数超过 50000 会自动按等步长抽样加速,但最终全部指标(F1、召回率、命中率、Lift 等)会在全体数据上精确重算,报告中会注明是否抽样。数据量超过 20 万时跳过重复行检查以节省内存。
Q: 输出的 HTML 报告需要联网吗?
A: 不需要。报告是自包含 HTML,CSS 和所有图表(散点图、PR 曲线、条形图)都内联在文件里,没有任何外部资源引用,用任何浏览器直接打开即可。
Q: 五种评估目标(objective)有什么区别?
A: f1(默认)= 精准率与召回率最平衡且都大(F1 最大);top_lift = 组合 Lift 前 5% 内命中率最小者;composite = lift×(1−命中率) 最大;max_lift = 命中率预算内最大化 lift;min_hit = lift 达标下最小化命中率。其中 f1/top_lift 不受 minBadCoverage 约束。
Q: 如何卸载?
A: 运行 dsh plugin --profile web remove dsh-plugin-risk-rule-design,然后重启 dsh web 即可。
Q: 自动剔除的 ID/流水号字段太多了,能不能保留?
A: 引擎按列名正则(如 _id、serialno、编号、手机号 等)+ 卡片基数(≈ 样本数视为近似唯一)+ 常量检测三条规则自动剔除 ID/serialno 列。如确需保留,可在 rrd_profiling 调用时用 features 显式指定要保留的列名。
上手难度
入门 — 准备一份 CSV(二分类标签)+ 调一次 rrd_mining 即可拿到最优组合与 HTML 报告;只有想精细调参(objective、cutQuantiles、branchMin 等)时才需要进一步理解逐层遍历树的搜索逻辑。
已知问题与限制
- 仅接受 CSV 文本,不直接读取 xlsx/excel;README 用例中出现
.xlsx路径会触发「找不到数据集文件」错误 - 目标列必须二分类:单一取值(b0=0 或 b0=1)、非二分类(出现 0/1/2 等多值)都会报错并提示合法取值范围
- 数据量 > 200000 行时跳过重复行检查(仅在 README/工具描述中以 info 级别提示,不阻断流程)
- 分类变量并集规则只贪心选前 12 个高坏浓度取值(
engine.js:390),对超多取值的分类列可能无法覆盖长尾 - README 开头自述「还在完善中,欢迎留言指正」,仍处于早期迭代阶段
- 重复行检查在内存中维护一个
Set(包含全部列拼接字符串),样本量在数十万级别时内存占用不可忽视
⚠️这个插件是东哥的第一个dsh插件,还在完善中;如使用中有不妥之处,欢迎各位留言指正。
一、插件介绍
一个面向 DeepSeek Harness 的第三方插件:蒸馏《100天风控专家》的思想和方法论,对指定数据集(X/y)进行 数据质检 → 单规则挖掘 → 并行规则集最优组合 → HTML分析报告 的完整流程,解决风控策略人员手动调策略的过程,提高工作效率。
插件注册 3 个工具 + 1 个专家技能:
| 能力 | 名称 | 说明 |
|---|---|---|
| 工具 | rrd_profiling | 第 1 步:X/y 确认与数据质量检查(自动剔除 ID/serialno/常量/近似唯一/高缺失列) |
| 工具 | rrd_mining | 第 2 步:单规则评估 + 并行规则集最优组合(遍历规则先后顺序)+ 默认生成 HTML 报告 |
| 工具 | rrd_report | 第 3 步:基于挖掘快照重新生成/调整 HTML 报告 |
| 技能 | risk-rule-design | 专家方法论(角色、流程、评判标准、报告结构),可被模型/用户加载 |
二、目录结构
risk_rule_design/
├── cordis.yml            # 插件补丁覆盖层(绝对路径版,源码直挂用 --patch 或合并进 profile)
├── cordis.patch.yml      # 插件补丁(npm 包形态,发布后由 dsh plugin 安装)
├── package.json          # npm 发布清单(零依赖)
├── LICENSE               # MIT
├── src/
│   ├── index.js          # 插件入口:注册工具与技能(零外部依赖)
│   ├── engine.js         # 挖掘引擎:CSV 解析、质检、单规则、组合规则搜索(纯逻辑)
│   └── report.js         # 自包含 HTML 报告生成(内联 CSS/SVG,无外部资源)
├── demo/
│   ├── make_demo_data.mjs    # 演示数据集生成器(含已知潜在规则结构)
│   └── report/smoke_report.html  # 演示输出样例(生成物,不入库)
└── test/
    ├── smoke.mjs         # 引擎 + 报告冒烟测试
    ├── load_plugin.mjs   # 插件模块加载测试(桩 ctx)
    └── run_tools.mjs     # 3 个工具端到端执行 + schema 一致性校验
三、安装
插件是纯 JavaScript(ESM),零构建、零外部依赖。
方式一:从npm安装(推荐)
dsh plugin --profile web install dsh-plugin-risk-rule-design
安装后重启 dsh web 生效;卸载:
dsh plugin --profile web remove dsh-plugin-risk-rule-design
✅ npm 包自带
dsh.bundle.patch,安装命令会自动把包注册进 profile 的dsh.profile.bundles,重启后工具与技能即可用,无需手动配置。
方式二:从Github安装(备选)
dsh plugin --profile web add "github:pypcfx-glitch/risk-rule-design"
⚠️ GitHub 直装只把包加入依赖,不会自动注册 bundle,需手动把包名追加到 profile 的
C:\Users\yaodyu\.dsh\profiles\web\package.json中:
"dsh": {
  "profile": {
    "bundles": [
      "@deepseek-ai/dsh-base",
      "@deepseek-ai/dsh-web-app",
      "risk-rule-design"
    ]
  }
}
然后重启 dsh web 生效。
提示:两种方式任选其一即可,无需重复安装;推荐方式一(npm 安装一键生效)。
四、使用流程
如何使用这个插件?
为了解决风控策略/数据分析人员的双手,你只需要准备分析样本即可(样本中需包括特征X和目标变量y)。
下面提供一个简单的对话命令模版。
敲入/调用插件risk-rule-design(安装成功后敲入risk应该会自动显示出来),然后将分析样本的绝对文件路径copy过来,并说明y的字段名。
最后执行就可以了。
/risk-rule-design
D:\...\model_data_v1.0.xlsx
分析这个数据集,剔除y_label_30和y_label_7,其中y_label_15是y,X请自行判断。
插件risk-rule-design会按照规则挖掘的分析流程自动执行,并生成报告,执行流转步骤如下:
rrd_profiling(dataset, target) ↓ 确认 X 清单 rrd_mining(dataset, target, features, [objective, hitRateBudget, minBadCoverage, ...]) ↓ 输出最优组合 + HTML 报告 + 快照 rrd_report(snapshot, [title, note]) # 可选
五、HTML报告结构及展示
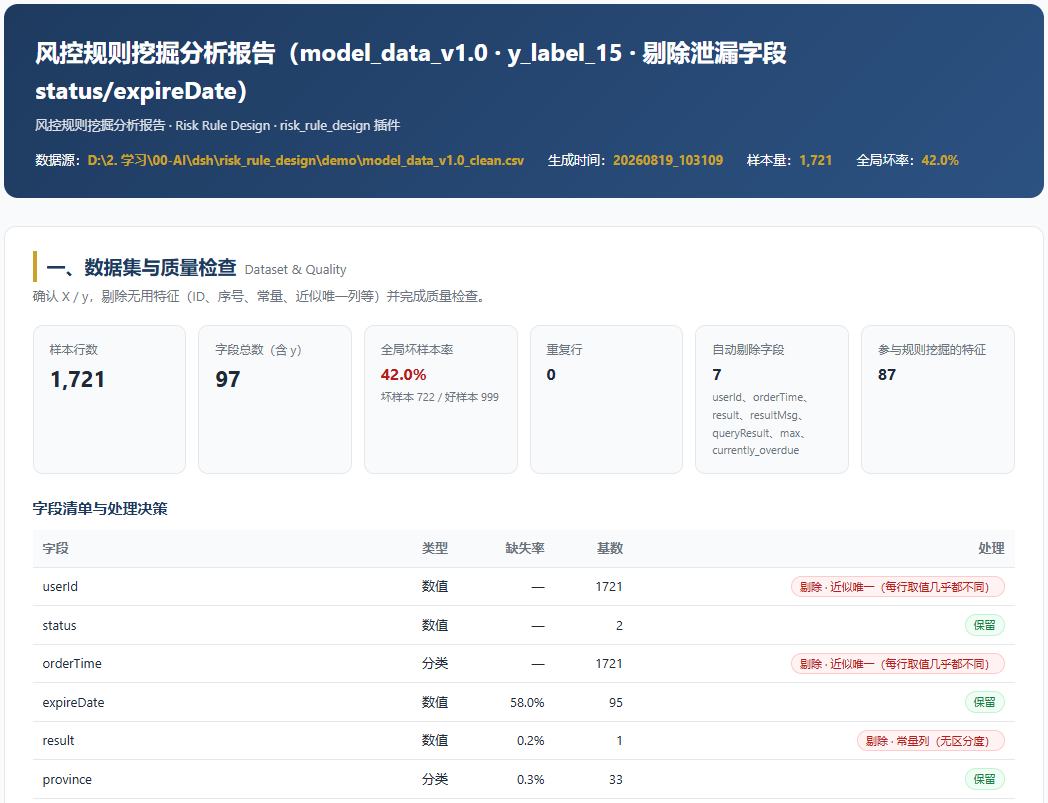
- 数据集与质量检查:样本/字段/坏率概览、字段清单与剔除决策、质量检查问题、y 分布;
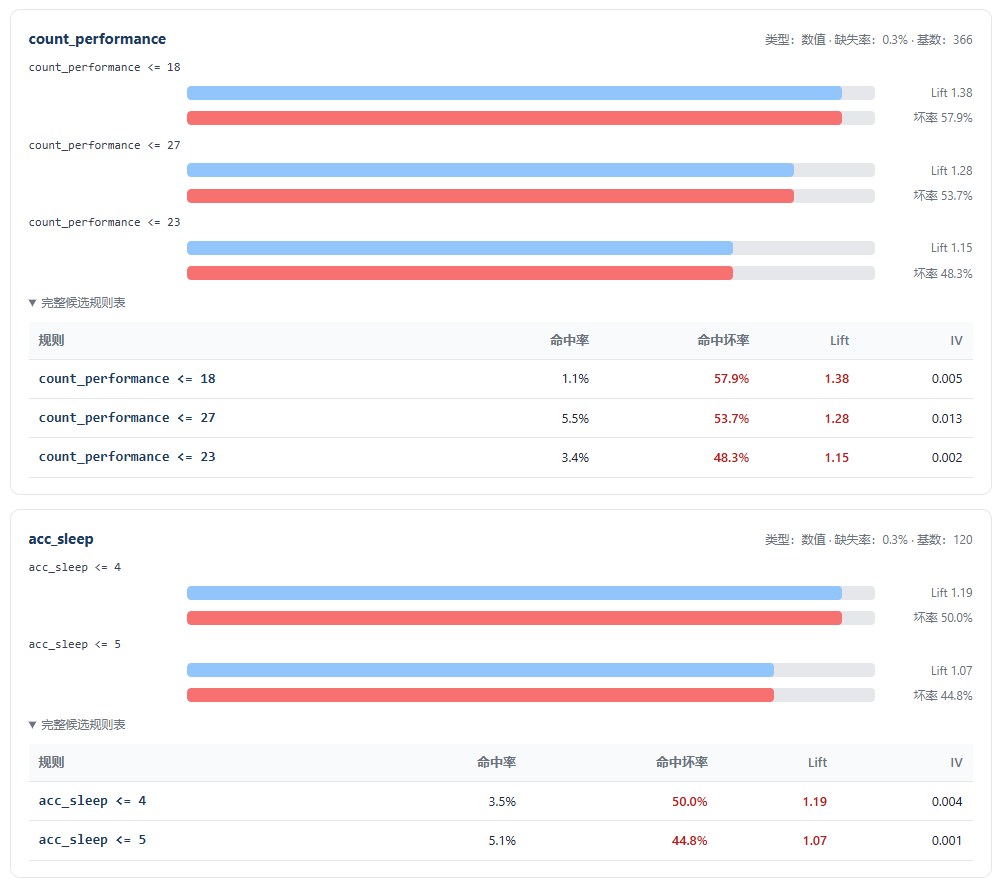
- 单变量效果分析:每个特征的候选规则(命中率、命中坏率、Lift、IV)与可视化条形图;
-
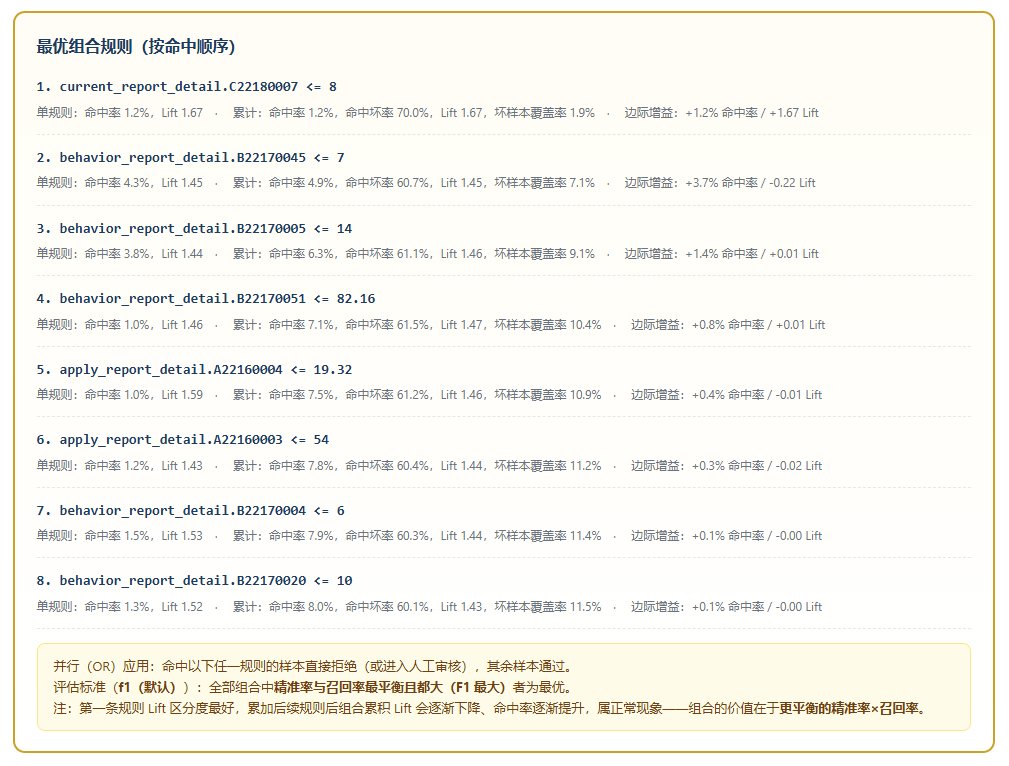
组合规则效果分析:
- 最优组合总览卡片(精准率、召回率、F1、命中率、Lift、拒绝样本数);
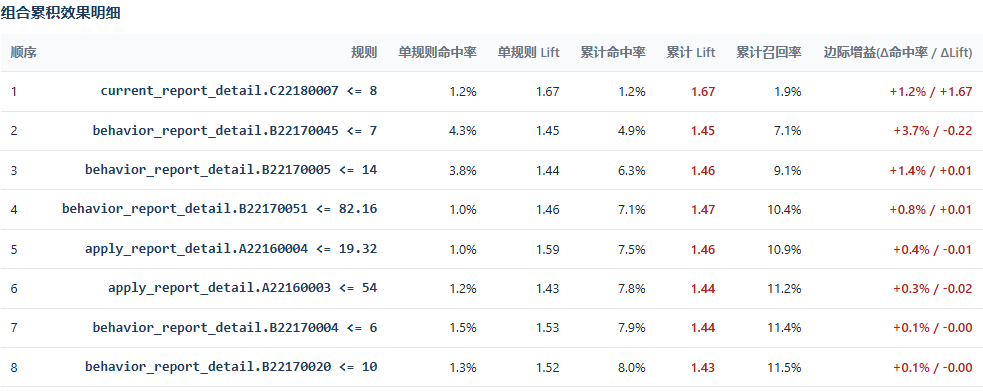
- 最优组合内所有规则 + 累积命中率 / Lift / 召回率 / 边际增益明细;
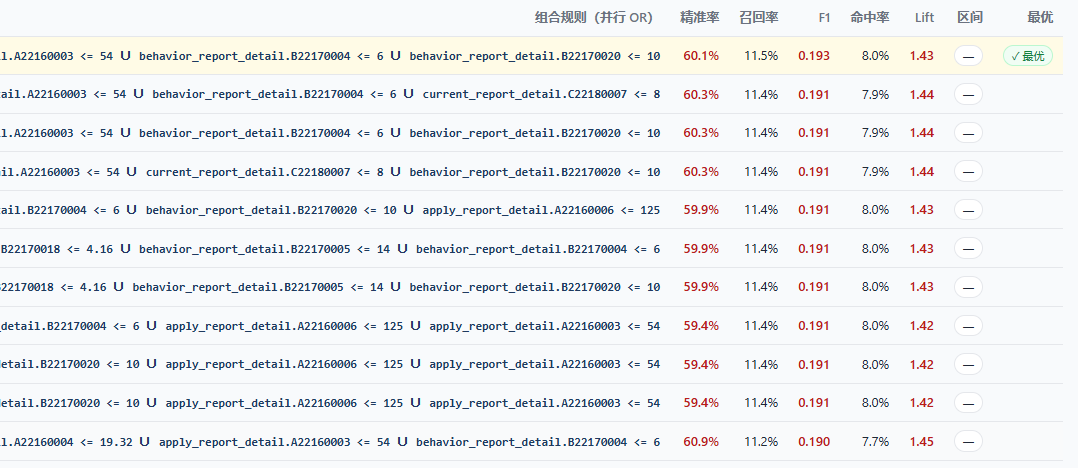
- 全部组合评估表(按 F1 降序):排名、组合规则、精准率、召回率、F1、命中率、Lift, 最优高亮(top_lift 目标时 ⭐ 标注 top5%);
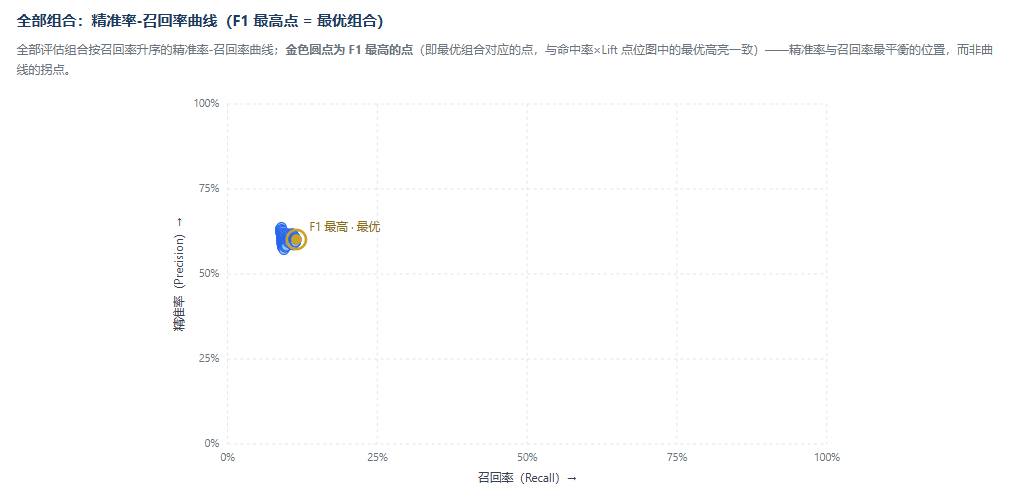
- 命中率 × Lift 点位图:全部组合散点,最优高亮(可见累加规则后沿「命中率↑、Lift↓」移动);
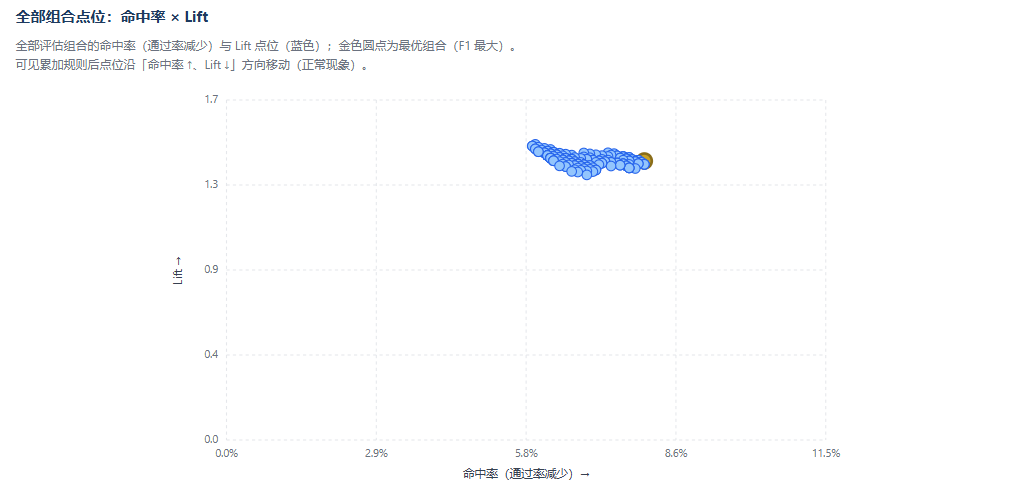
- 精准率-召回率曲线:全部组合曲线,标注 F1 最高点(即最优组合对应的点),而非拐点;
- 候选规则池与入选情况;
-
附录:分析配置与约束说明。
报告为自包含 HTML(内联 CSS/SVG,无外部资源),可直接用浏览器打开。
查看使用指南 →
该插件的安装步骤、关键要点、FAQ 与兼容性说明(基于已收录字段派生)。
收录徽章

[](https://deepseek-plugin.org/plugins/pypcfx-glitch/risk-rule-design)把这段 markdown 粘贴到你的 GitHub README,链接回本插件详情页。徽章只声明已被本站收录,不代表安全认证。